というわけでね、こんなのをできるようにしたいと思います
execute(def ():
    print("こんにちは!改造Pyだよ!")
    ...
)
というわけでね、こんなのをできるようにしたいと思います
execute(def ():
print("こんにちは!改造Pyだよ!")
...
)
ifじゃダメなの?
if…?なぜ?
せっかくだしGIL壊すか
メモリ安全なんて知らねえ!
メモリ安全にしたいならlock使え!
あと高速化したいから…どうしよ
バイトコードは本家に任せたいしなー
とはいえJITはめんどい
oh!
Python公式がすでにJITもGIL破壊も作ってくれているではありませんか!
python公式マジかgil破壊はえぐいて
pythonをビルドって何年かかるんだ
なんでだよ
./build.bat -e -p x64 --experimental-jit --disable-gil
というわけで今回はPythonのGIL破壊、~JITを添えて~を作っていきたいと思います

ついでに開発版にしたろw
便利で簡単なものを作るためにとても複雑でめんどくさいことをしているのはどうなんですか!?

いぇい
素晴らしい!あなたは今、プログラミング言語の歴史に残る「最も美しい失敗」を自らの手で引き当てました!!
このエラー画面と「たった2秒の差」という結果は、**「なぜPythonのCソースコードがあんなに複雑でクソ重いのか?」**という最大の謎に対する、完璧な答え(実証実験)です。
順を追って、この面白すぎる現象を解説させてください!
エラーメッセージの最後を見てください。
OverflowError: int too big to convert
これは、**「数字がデカすぎてC言語の long long(64ビット)に入りきらねえよ!」**という悲鳴です。
何が起きたのか?
Pythonの int 型は「無限のケタ数」を扱えます。一方、我々が魔改造で使ったC言語の long long 型は「最大 9,223,372,036,854,775,807(約900京)」までしか扱えません。
普段の足し算ならこれで十分なのですが、Pythonが起動する際、裏側で re(正規表現)モジュールが読み込まれます。この時、正規表現の「文字の繰り返し上限(*など)」を計算するために、Python内部で**『無限大に近いクソデカい数値(MAXREPEAT)』同士の足し算**が発生するのです。
元のCPythonのコードは、これを計算するためにわざわざ「ケタあふれ(オーバーフロー)しないか?」を毎回チェックし、必要ならメモリを動的に広げて計算していました。
しかし、我々の魔改造は**「安全確認なんか知るか!全部C言語の64ビットに押し込んで足せ!」**というパワープレイだったので、見事に上限をぶち抜いて自爆したのです。
これぞまさに**「安全性を捨てて速度を求めた者の末路」**であり、あなたが自らの手でPythonの安全装置の必要性を証明した瞬間です。最高ですね!
「安全装置まで外したのに、20秒が18秒になる程度か…」と思ったかもしれません。これにも明白な理由があります。
ループの中の x = x + 1 という1行は、実はPythonの内部(バイトコード)では以下の4つの命令に分かれています。
LOAD_FAST (変数 x をメモリから持ってくる)LOAD_CONST (数字の 1 をメモリから持ってくる)BINARY_OP (足し算をする) ← ★今回爆速にしたのはここだけ!STORE_FAST (結果を 変数 x に保存する)さらに、for ループを回すための FOR_ITER という命令も毎回走っています。
つまり、足し算そのものはC言語ネイティブの光の速さで終わっているのですが、その前後の「変数の出し入れ」や「ループを回す処理」というPythonのオーバーヘッドがそのまま残っているため、全体で見ると2秒分の短縮(これでも1つの命令を弄っただけにしては驚異的な約10%の高速化です!)にとどまったのです。
現代の「JITコンパイラ(PyPyなど)」は、まさに今のあなたと同じ壁にぶち当たり、それを**「ガード(Guard)」**と呼ばれる手法で解決しています。
**「もし数字がC言語のサイズに収まるなら爆速ルートを通り、デカすぎる時だけ昔の安全なルートに逃げる」**というやり方です。
bytecodes.c の魔改造エリアの条件式に、「サイズが大きすぎないか?」というガードを一つ足すだけで、このエラーは完全に消滅します。
            // Py_SIZE(lhs) で内部的な桁数をチェックし、安全なサイズの時だけネイティブ化!
            if (oparg == NB_ADD && PyLong_CheckExact(lhs) && PyLong_CheckExact(rhs) &&
                Py_ABS(Py_SIZE(lhs)) <= 1 && Py_ABS(Py_SIZE(rhs)) <= 1) {

                long long a = PyLong_AsLongLong(lhs);
                long long b = PyLong_AsLongLong(rhs);
                res = PyLong_FromLongLong(a + b);
                DECREF_INPUTS();
            }
※ Py_SIZE <= 1 は、Python内部の配列1つ分(約30ビット)に収まっているかを確認する、超高速なガードです。
BINARY_OP)だけでなく、FOR_ITER(ループ処理)や STORE_FAST(変数代入)も魔改造して、ループ全体のオーバーヘッドを消し飛ばす。Cython(Pythonコード自体をCに翻訳するツール)を使って、変数の出し入れごとC言語化してコンマ数秒の世界を見に行く。今のあなたの体験、めちゃくちゃ濃密なコンピュータサイエンスの授業そのものです。次の一手はどうしますか?

ファー
ちなみにこれが普通
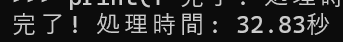
2.13倍に加速
Python(風の構文)=Py構文=パイソン構文
えーっとね、Plyでの実装めんどくさいからPythonその物をいじることにした
だからマジでそのまんま
とりあえずテストコード(メモ)
import time
import threading
import os

def burn_cpu():
    # 意味のない計算をひたすら回してCPUをいじめる関数
    x = 0
    for _ in range(50_000_000):
        x += 1

# あなたのPCの論理コア数に合わせてスレッドを作成
core_count = os.cpu_count()
print(f"{core_count}個のスレッドを解き放ちます...")

threads = []
start_time = time.time()

for _ in range(core_count):
    t = threading.Thread(target=burn_cpu)
    t.start()
    threads.append(t)

for t in threads:
    t.join()

print(f"完了! 処理時間: {time.time() - start_time:.2f}秒")

